Domain vloc.de kaufen?
Wir ziehen mit dem Projekt
vloc.de um.
Sind Sie am Kauf der Domain
vloc.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain vloc.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
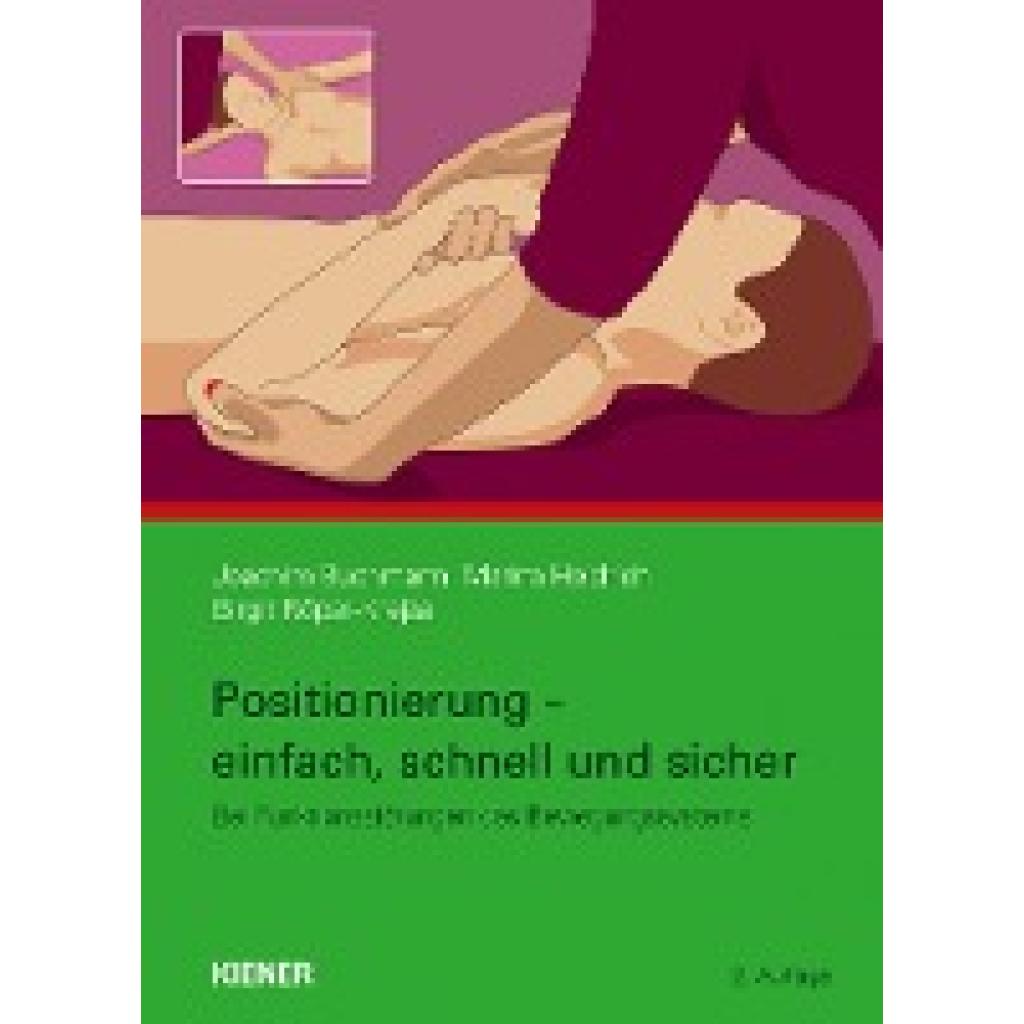
Buchmann, Joachim: Positionierung - einfach, schnell und sicherPositionierung - einfach, schnell und sicher , Nur ein Jahr nach Erscheinen der ersten Auflage liegt nun die zweite, überarbeitete Auflage des Buches vor! Es wurde von den Autoren gründlich durchgearbeitet und ergänzt um die Positionierungsbehandlung bei ulnarer Epikondylopathie sowie um wertvolle Informationen in den Exkursen aus dem Erfahrungsschatz der Autoren. Dieses "Praxis-Bilderbuch" bietet eine außerordentlich präzise und praktikable Anleitung mit Punkt-für-Punkt-Handlungsanweisungen und einprägsamen Zeichnungen. Die Autoren beschreiben ihr Konzept für eine Weiterentwicklung und Optimierung der von Lawrence Jones entwickelten Strain-Counterstrain-Technik. Der Therapeut wird im Buch Schritt für Schritt durch die Behandlung der verschiedenen Körperregionen geführt. Die Grundlage von Jones' Theorie ist die Beobachtung, dass Patienten jeden Schmerz innerhalb des Bewegungssystems durch eine bestimmte Körperposition versuchen zu reduzieren. Er fand Zonen vermehrter Spannung an der Körperoberfläche, Tenderpoints genannt, die für ihn Hinweis auf schmerzhafteFunktionsbeeinträchtigung und gleichzeitig Ausgangspunkt der Behandlung waren. Die Strain-Counterstrain-Technik ist darauf gerichtet, über eine für den Patienten schmerzarme, im besten Fall schmerzfreie Positionierung eine Dysfunktion und die damit verbundene Spannungsvermehrung zu beseitigen.. Die Methode basiert auf neurophysiologischen Überlegungen. Sie erfordert jedoch langsame Positionierungs- und Palpationsschritte und verursacht damit einen immensen Zeitaufwand. Dies führte die Autoren zu der Überlegung, ob nicht Fazilitationstechniken im Rahmen der Durchführung der Methode diesen Zeitaufwand reduzieren könnten. Sie entwickelten ein nahezu durchgängig mit Kompression, gelegentlich auch mit Traktion arbeitendes Behandlungsvorgehen, das bei unverminderter Effektivität eine entscheidende Zeitoptimierung ermöglicht. Daraus wiederum entstand eine detaillierte Handlungsanweisung für das Auffinden von Tenderpoints, deren Zuordnung zu Funktionsstörungen am Bewegungssystem und zum jeweiligen therapeutischen Vorgehen. , Seife > Autopflege & Aufbereitung , Erscheinungsjahr: 201907, Produktform: Kartoniert, Autoren: Buchmann, Joachim~Heidrich, Marina~Röper-Krejza, Birgit, Edition: REV, Auflage: 19002, Seitenzahl/Blattzahl: 205, Abbildungen: über 150 Abbildungen, Keyword: Bewegungsapparat; Bewegungsbeeinträchtigung; Epicondylitis; Faszillationstechniken; Funktionsfähigkeit; Halswirbelsäule; Iliosakralgelenk; Kompression; Manuelle Behandlung; Manuelle Therapie; Neurophysiologie; Osteopathie; Palpation; Physiotherapie; Schmerz; Schmerzbehandlung; Strain-Counterstrain-Technik; Tenderpoints; Traktion; ulnare Epikondylopathie, Fachschema: Chiropraktik~Manuelle Medizin / Chiropraktik~Osteopathie~Wirbelsäule / Osteopathie~Orthopädie~Physikalische Therapie~Physiotherapie, Fachkategorie: Physiotherapie~Chiropraktik und Osteopathie, Warengruppe: HC/Alternative Medizin/Naturmedizin/Homöopathie, Fachkategorie: Orthopädie und Brüche, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kiener Verlag, Verlag: Kiener Verlag, Verlag: KIENER Verlag, Länge: 269, Breite: 198, Höhe: 17, Gewicht: 698, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger EAN: 9783943324730, Herkunftsland: POLEN (PL), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 200044562,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Buchmann, Joachim: Positionierung - einfach, schnell und sicherPositionierung - einfach, schnell und sicher , Nur ein Jahr nach Erscheinen der ersten Auflage liegt nun die zweite, überarbeitete Auflage des Buches vor! Es wurde von den Autoren gründlich durchgearbeitet und ergänzt um die Positionierungsbehandlung bei ulnarer Epikondylopathie sowie um wertvolle Informationen in den Exkursen aus dem Erfahrungsschatz der Autoren. Dieses "Praxis-Bilderbuch" bietet eine außerordentlich präzise und praktikable Anleitung mit Punkt-für-Punkt-Handlungsanweisungen und einprägsamen Zeichnungen. Die Autoren beschreiben ihr Konzept für eine Weiterentwicklung und Optimierung der von Lawrence Jones entwickelten Strain-Counterstrain-Technik. Der Therapeut wird im Buch Schritt für Schritt durch die Behandlung der verschiedenen Körperregionen geführt. Die Grundlage von Jones' Theorie ist die Beobachtung, dass Patienten jeden Schmerz innerhalb des Bewegungssystems durch eine bestimmte Körperposition versuchen zu reduzieren. Er fand Zonen vermehrter Spannung an der Körperoberfläche, Tenderpoints genannt, die für ihn Hinweis auf schmerzhafteFunktionsbeeinträchtigung und gleichzeitig Ausgangspunkt der Behandlung waren. Die Strain-Counterstrain-Technik ist darauf gerichtet, über eine für den Patienten schmerzarme, im besten Fall schmerzfreie Positionierung eine Dysfunktion und die damit verbundene Spannungsvermehrung zu beseitigen.. Die Methode basiert auf neurophysiologischen Überlegungen. Sie erfordert jedoch langsame Positionierungs- und Palpationsschritte und verursacht damit einen immensen Zeitaufwand. Dies führte die Autoren zu der Überlegung, ob nicht Fazilitationstechniken im Rahmen der Durchführung der Methode diesen Zeitaufwand reduzieren könnten. Sie entwickelten ein nahezu durchgängig mit Kompression, gelegentlich auch mit Traktion arbeitendes Behandlungsvorgehen, das bei unverminderter Effektivität eine entscheidende Zeitoptimierung ermöglicht. Daraus wiederum entstand eine detaillierte Handlungsanweisung für das Auffinden von Tenderpoints, deren Zuordnung zu Funktionsstörungen am Bewegungssystem und zum jeweiligen therapeutischen Vorgehen. , Seife > Autopflege & Aufbereitung , Erscheinungsjahr: 201907, Produktform: Kartoniert, Autoren: Buchmann, Joachim~Heidrich, Marina~Röper-Krejza, Birgit, Edition: REV, Auflage: 19002, Seitenzahl/Blattzahl: 205, Abbildungen: über 150 Abbildungen, Keyword: Bewegungsapparat; Bewegungsbeeinträchtigung; Epicondylitis; Faszillationstechniken; Funktionsfähigkeit; Halswirbelsäule; Iliosakralgelenk; Kompression; Manuelle Behandlung; Manuelle Therapie; Neurophysiologie; Osteopathie; Palpation; Physiotherapie; Schmerz; Schmerzbehandlung; Strain-Counterstrain-Technik; Tenderpoints; Traktion; ulnare Epikondylopathie, Fachschema: Chiropraktik~Manuelle Medizin / Chiropraktik~Osteopathie~Wirbelsäule / Osteopathie~Orthopädie~Physikalische Therapie~Physiotherapie, Fachkategorie: Physiotherapie~Chiropraktik und Osteopathie, Warengruppe: HC/Alternative Medizin/Naturmedizin/Homöopathie, Fachkategorie: Orthopädie und Brüche, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kiener Verlag, Verlag: Kiener Verlag, Verlag: KIENER Verlag, Länge: 269, Breite: 198, Höhe: 17, Gewicht: 698, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger EAN: 9783943324730, Herkunftsland: POLEN (PL), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 200044562,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
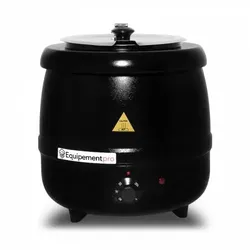
Professioneller Suppenwärmer 10L Edelstahl 400W – Schnell & Zuverlässig für GastronomieMit diesem professionellen Suppenwärmer 10 Liter halten Sie Suppen und Saucen während des gesamten Service perfekt warm. Ideal für Gastronomie, Buffets und Großküchen, überzeugt er durch seine robuste Edelstahlkonstruktion, hohe Leistung und eine herausnehmbare Einsatzschale für leichte Reinigung. Mit 400W Leistung bietet er schnelles Aufheizen und ist bestens für den intensiven Einsatz geeignet. Hauptvorteile: 10 Liter Fassungsvermögen – ideal für Suppen & Saucen Edelstahlgehäuse – langlebig & leicht zu reinigen 400W Leistung für schnelles Erwärmen Integrierter Thermostat für präzise Temperaturregelung Herausnehmbarer Einsatz für einfaches Reinigen Perfekt für die professionelle Gastronomie geeignet Technische Daten: Leistung: 400W / 230V Kapazität: 10L Maße: 370 x 370 x 380 mm Gewicht: 5 kg83,29 €*Versand: 14,28 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.